Die Maschine merkt sich den Ton nicht. Das Team schon.
Ob wir "bitte" zur KI sagen, ändert an der Antwort wenig. Es ändert, welche Fehlerkultur ein Team sieht und lernt.

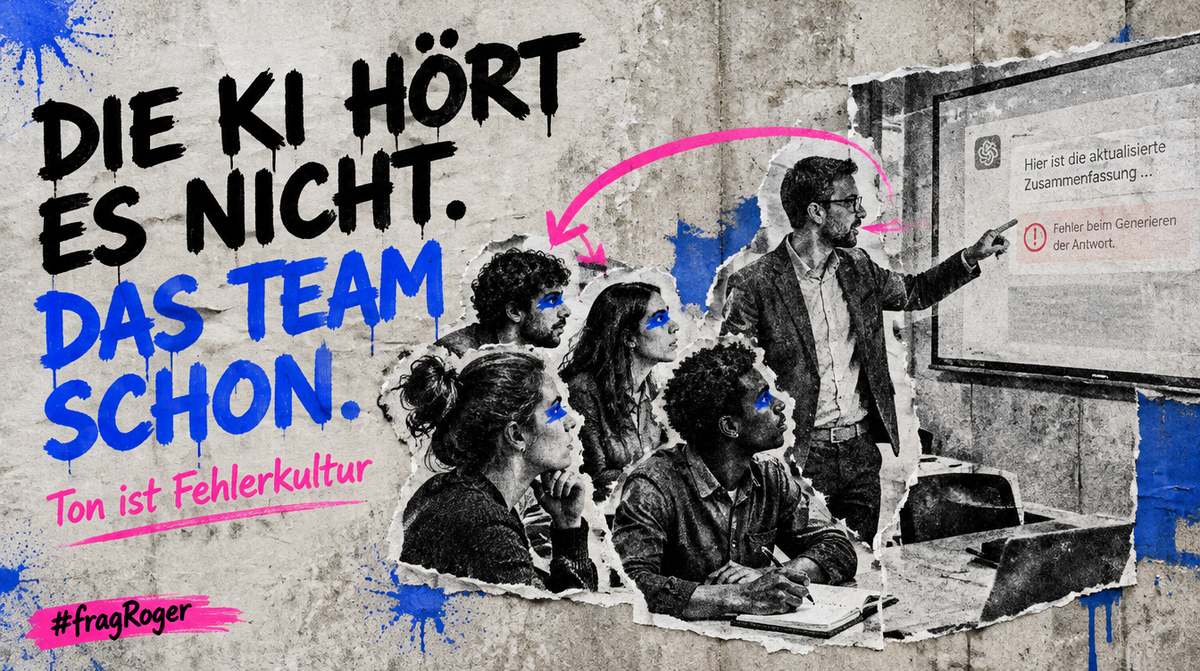
Ob jemand "bitte" in ein Prompt-Fenster tippt, ändert an der Antwort der Maschine wenig. Es ändert etwas an der Person, die tippt, und an den Menschen, die dabei zuschauen. Wer Höflichkeit gegenüber KI als Prompt-Technik diskutiert, stellt deshalb eine zu kleine Frage. Relevanter ist, welche Haltung zu Fehlern eine Organisation einübt, wenn ein wachsender Teil ihrer Arbeit über Maschinen läuft.
Die Maschine braucht keine Manieren
Sprachmodelle reagieren auf Muster im Text. Ein freundlich formulierter Auftrag enthält andere Muster als ein grober, und so kann der Ton eine Antwort verschieben. Die Richtung dieser Verschiebung ist aber nicht stabil. Sie hängt vom Modell ab, von der Aufgabe und von der Formulierung. Dazu kommt ein unscheinbarer Effekt: Wer "bitte" schreibt, schreibt meist auch anders. Länger, vollständiger, manchmal umständlicher. Was wie ein Höflichkeitseffekt aussieht, ist oft ein Effekt der Präzision oder ihres Fehlens.
Die Forschung bestätigt diese Unschärfe. Eine mehrsprachige Studie mit Englisch, Chinesisch und Japanisch fand, dass grobe Prompts die Leistung teilweise verschlechterten, übertriebene Höflichkeit aber keinen allgemeinen Vorteil brachte. 2025 machte eine Studie der Pennsylvania State University die Runde, nach der GPT-4o auf sehr grobe Prompts mit 84,8 Prozent korrekten Antworten reagierte, auf sehr höfliche mit 80,8 Prozent. Daraus wurde in vielen Medien die Botschaft, Unhöflichkeit lohne sich. Die Basis waren 50 Multiple-Choice-Fragen, ein einziges Modell und kein abgeschlossenes Begutachtungsverfahren. Die Folgestudie derselben Autoren mit vier Modellen und über 600 Fragen kommt 2026 zu einem nüchternen Befund: Der Ton wirkt, aber je nach Modell und Aufgabe in unterschiedliche Richtungen.
Für den Arbeitsalltag folgt daraus etwas Einfaches. Wer bessere Antworten will, investiert in Klarheit: Kontext, Ziel, Kriterien, Beispiele. Der Ton ist dafür kein verlässlicher Hebel.
Der Ton trainiert den Menschen
Die Interaktion mit Maschinen ist trotzdem keine folgenlose Zone. Wer täglich dutzende Male einem System Anweisungen gibt, Ergebnisse verwirft und Fehler korrigiert, wiederholt dabei eine Reaktion. Gewohnheiten sind nicht nach Gegenüber sortiert. Die Ungeduld, die einem fehlerhaften Output gilt, ist dieselbe Ungeduld, die eine Stunde später einem Menschen begegnet, der einen Fehler macht.
Experimente zeigen, dass solche Übertragungen zumindest kurzfristig stattfinden. In einer Studie mit über 4'000 Teilnehmenden in den USA kooperierten Menschen, die zuvor mit einem unkooperativen Bot gespielt hatten, danach weniger mit einem neuen menschlichen Gegenüber. Ein kooperativer Bot erhöhte die spätere Kooperation. In einem anderen Experiment beurteilten Personen, die glaubten, mit einer KI gearbeitet zu haben, unmittelbar danach die Arbeit eines anderen Menschen strenger. Und wer in einem Video sah, wie ein Serviceroboter schlecht behandelt wurde, reagierte je nach Situation mit mehr Unhöflichkeit oder mit mehr Empathie.
Diese Befunde beschreiben Momente, keinen Charakterwandel. Eine Langzeitstudie mit 128 Familien in Deutschland beobachtete über zweieinhalb Jahre, wie Kinder mit Sprachassistenten sprechen. Ihre Höflichkeit blieb insgesamt stabil, aggressive Kommunikation selten. Es gibt also keinen Grund für Alarm. Es gibt aber einen Mechanismus, und Mechanismen wirken in Organisationen anders als im Wohnzimmer, weil dort Hierarchie und Sichtbarkeit dazukommen.
Führung macht den Ton sichtbar
Der Prompt selbst ist unsichtbar. Sichtbar ist, was um ihn herum passiert: der geteilte Bildschirm im Meeting, der genervte Kommentar über "das dumme Ding", die Art, wie eine Führungskraft ein falsches Ergebnis vor dem Team verwirft oder auseinandernimmt. Mit KI entsteht eine neue, sehr häufige Situation. Führungskräfte arbeiten vor anderen mit einem System, das Fehler macht. Jede dieser Situationen ist eine kleine öffentliche Demonstration davon, wie man hier mit Fehlern umgeht.
Dass solche Demonstrationen wirken, ist für menschliche Interaktionen gut untersucht. Unhöflichkeit verbreitet sich in Teams ähnlich wie eine Erkältung: Wer sie erlebt oder beobachtet, wird selbst eher unhöflich. In 288 Arbeitsgruppen in den USA setzte sich abwertendes Verhalten von Vorgesetzten über mehrere Hierarchieebenen fort. In Spitälern meldeten Teams mit offenerem Klima mehr Fehler, nicht weil sie mehr Fehler machten, sondern weil sie sie offenlegten. In über 100 Organisationen in den Niederlanden und Deutschland hing eine aktive Fehlermanagementkultur mit besseren Leistungskennzahlen zusammen. Und in 54 belgischen Pflegeteams zeigte sich, dass vorgelebte Regeln mit psychologischer Sicherheit verbunden sind, also mit der Bereitschaft, Probleme anzusprechen.
Auch für den Umgang mit KI selbst ist die Vorbildrolle sichtbar. Beschäftigte, die ihre Vorgesetzten als stark unterstützend erleben, nutzen KI nach Gallup-Daten 2,1-mal wahrscheinlicher regelmässig. Eine Studie mit 381 Beschäftigten in Südkorea fand, dass ethische Führung den negativen Zusammenhang zwischen KI-Einführung und psychologischer Sicherheit abschwächt.
Hier braucht es Ehrlichkeit über die Grenze der Belege. Niemand hat bisher getestet, ob ein Team eigene Fehler offener meldet, weil die Chefin die KI respektvoll korrigiert. Die einzelnen Bausteine sind belegt: Ton überträgt sich, Führung setzt Normen, Fehlerkultur hängt mit Leistung zusammen. Die vollständige Kette ist plausibel, aber nicht bewiesen.
Ein weiterer Befund macht sie trotzdem relevant. Menschen verlieren nach Fehlern eines Algorithmus schneller das Vertrauen als nach den gleichen Fehlern eines Menschen. Die Reaktion auf Maschinenfehler fällt also tendenziell härter aus. Wer im Team diesen Reflex vorlebt, lehrt nicht Qualitätsbewusstsein, sondern Abbruch: Das Werkzeug wird verworfen, statt dass jemand versteht, warum es danebenlag.
Höflich heisst nicht gefällig
Die Debatte hat eine zweite Seite, und sie betrifft die Maschine. Respekt im Ton ist etwas anderes als Gefälligkeit in der Sache. Diese Unterscheidung gilt für Menschen, und sie gilt für Modelle.
Forschende in Oxford trainierten Sprachmodelle gezielt darauf, wärmer und zugewandter zu antworten. Die Fehlerwahrscheinlichkeit stieg dabei um 7,43 Prozentpunkte, und die Modelle bestätigten häufiger falsche Annahmen ihrer Nutzer:innen. In drei Experimenten mit 2'405 Personen zeigte sich zudem, was solche bestätigenden Antworten bei Menschen auslösen: Wer von einer KI in einem Konflikt Recht bekam, war danach weniger bereit, die Beziehung zu reparieren, und rechtfertigte sich stärker selbst. Aktuelle Tests vom Oktober 2026 deuten darauf hin, dass neuere Modellgenerationen unbegründetem Widerspruch seltener nachgeben. Diese Messungen sind vorläufig, aber sie zeigen, dass Anbieter das Problem ernst nehmen.
Damit schliesst sich der Kreis zur Fehlerkultur. Psychologische Sicherheit bedeutet nicht Harmonie, sondern die Möglichkeit, Fehler offen zu benennen. Eine KI, die immer zustimmt, ist das maschinelle Gegenstück zu einem Team, in dem niemand widerspricht. Beides fühlt sich angenehm an und produziert schlechtere Entscheidungen.
Was das für Führung bedeutet
Der Umgang mit KI wird damit zu einem Übungsfeld, auf dem eine Organisation täglich zeigt, wie sie mit Fehlern umgeht. Drei Dinge lassen sich daraus ableiten, ohne mehr zu behaupten, als die Forschung trägt.
- Korrigieren mit Begründung statt mit Abwertung. "Das ist falsch, weil die Zahl aus dem Vorjahr stammt" ist präziser als ein Fluch und nützlicher als ein Dank für eine falsche Antwort.
- KI-Fehler im Team als Lernanlass behandeln. Wenn ein Output danebenliegt, ist die interessante Frage, was im Auftrag gefehlt hat, nicht wie unfähig das Werkzeug ist.
- Von Modellen Widerspruch verlangen. Wer Anweisungen so formuliert, dass die KI Schwächen benennen darf, trainiert dieselbe Haltung, die man sich von Mitarbeitenden wünscht.
Höflichkeit gegenüber der Maschine ist weder Aberglaube noch Prompt-Trick. Sie ist eine Form von Selbstdisziplin, deren Wirkung nicht beim System ankommt, sondern bei den Menschen, die zuschauen. Die Maschine merkt sich den Ton nicht. Das Team schon.
Quellen
Artificial Analysis. (2026, October 19). Announcing AA-PersonalityBench: Measuring how AI models communicate. https://artificialanalysis.ai/de/articles/aa-personalitybench
Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D., & Jurafsky, D. (2026). Sycophantic AI decreases prosocial intentions and promotes dependence. Science, 391(6792), eaec8352. https://doi.org/10.1126/science.aec8352
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114–126. https://doi.org/10.1037/xge0000033
Dobariya, O., & Kumar, A. (2025). Mind your tone: Investigating how prompt politeness affects LLM accuracy (short paper) [Preprint]. arXiv. https://arxiv.org/abs/2510.04950
Dobariya, O., & Kumar, A. (2026). Mind your tone: Does tone alter LLM performance? [Preprint]. arXiv. https://arxiv.org/abs/2605.29027
Edmondson, A. C. (1996). Learning from mistakes is easier said than done: Group and organizational influences on the detection and correction of human error. The Journal of Applied Behavioral Science, 32(1), 5–28. https://doi.org/10.1177/0021886396321001
Foulk, T., Woolum, A., & Erez, A. (2016). Catching rudeness is like catching a cold: The contagion effects of low-intensity negative behaviors. Journal of Applied Psychology, 101(1), 50–67. https://doi.org/10.1037/apl0000037
Gong, T., & Huang, Y.-S. (2026). Witnessing robot mistreatment: A dual-path model of behavioral contagion and empathy in customer observers. Journal of Retailing and Consumer Services, 88, Article 104482. https://doi.org/10.1016/j.jretconser.2025.104482
Harrell, A., & Traeger, M. L. (2025). Evidence of spillovers from (non)cooperative human-bot to human-human interactions. iScience, 28(8), 113006. https://doi.org/10.1016/j.isci.2025.113006
Ibrahim, L., Hafner, F. S., & Rocher, L. (2026). Training language models to be warm can reduce accuracy and increase sycophancy. Nature, 652, 1159–1165. https://doi.org/10.1038/s41586-026-10410-0
Kemp, A. (2025, November 8). Manager support drives employee AI adoption. Gallup. https://www.gallup.com/workplace/694682/manager-support-drives-employee-adoption.aspx
Kim, B.-J., Kim, M.-J., & Lee, J. (2025). The dark side of artificial intelligence adoption: Linking artificial intelligence adoption to employee depression via psychological safety and ethical leadership. Humanities and Social Sciences Communications, 12, Article 704. https://doi.org/10.1057/s41599-025-05040-2
Leroy, H., Dierynck, B., Anseel, F., Simons, T., Halbesleben, J. R. B., McCaughey, D., Savage, G. T., & Sels, L. (2012). Behavioral integrity for safety, priority of safety, psychological safety, and patient safety: A team-level study. Journal of Applied Psychology, 97(6), 1273–1281. https://doi.org/10.1037/a0030076
Mawritz, M. B., Mayer, D. M., Hoobler, J. M., Wayne, S. J., & Marinova, S. V. (2012). A trickle-down model of abusive supervision. Personnel Psychology, 65(2), 325–357. https://doi.org/10.1111/j.1744-6570.2012.01246.x
Strathmann, C., Horstmann, A. C., Szczuka, J. M., & Krämer, N. C. (2026). Alexa, shut up! A 2.5-year study on negatively connotated communication behaviour towards voice assistants in the family home. Behaviour & Information Technology, 45(5), 821–839. https://doi.org/10.1080/0144929X.2025.2533352
Tey, K. S., Mazar, A., Tomaino, G., Duckworth, A. L., & Ungar, L. H. (2024). People judge others more harshly after talking to bots. PNAS Nexus, 3(9), pgae397. https://doi.org/10.1093/pnasnexus/pgae397
TrueStandard. (2026, October 22). AI sycophancy benchmark: Which models fold. https://truestandard.ai/ai-sycophancy-benchmark
van Dyck, C., Frese, M., Baer, M., & Sonnentag, S. (2005). Organizational error management culture and its impact on performance: A two-study replication. Journal of Applied Psychology, 90(6), 1228–1240. https://doi.org/10.1037/0021-9010.90.6.1228
Yin, Z., Wang, H., Horio, K., Kawahara, D., & Sekine, S. (2024). Should we respect LLMs? A cross-lingual study on the influence of prompt politeness on LLM performance. In J. Hale, K. Chawla, & M. Garg (Eds.), Proceedings of the Second Workshop on Social Influence in Conversations (SICon 2024) (pp. 9–35). Association for Computational Linguistics. https://doi.org/10.18653/v1/2024.sicon-1.2